Llegas de NumPy. Abres un DataFrame por primera vez. Escribes df.loc[0] y funciona. Respiras. Lo repites en otro contexto y… KeyError: 0. La pantalla se queda ahí, mirándote, como si el código se riera de ti.
A todos nos ha pasado. Es el tropiezo nº1 al cruzar la frontera de NumPy a Pandas, y no tiene que ver con que Pandas “sea raro”. Tiene que ver con una confusión concreta: en Pandas, el número entre corchetes puede significar dos cosas distintas, y la elección entre .loc e .iloc le dice al intérprete cuál de las dos quieres.
La regla que cabe en una línea
.loc mira las etiquetas que ves al imprimir el DataFrame (los nombres del índice y de las columnas). .iloc mira la posición que esa fila o columna ocupa empezando a contar desde 0, como en una lista de Python. Si tu índice es 0, 1, 2, 3, las dos cosas coinciden y el error se esconde. En el momento en que las etiquetas dejan de coincidir con la posición, una de las dos te está mintiendo.
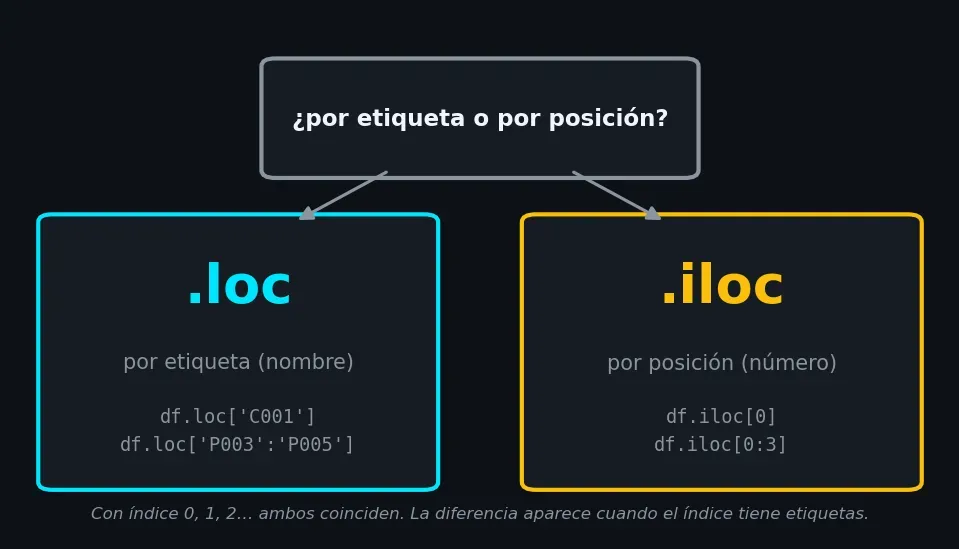
El diagrama es deliberadamente simple: primero decides qué te importa —el nombre o el orden— y luego eliges el método. No al revés. La mayoría de errores que veo en clase vienen de elegir el método primero y razonar después.
El caso que rompe la intuición
Empiezas con un índice numérico “razonable” y todo va bien:
import pandas as pd

df = pd.DataFrame({'precio': [100, 200, 300]})
df.loc[0]   # fila con etiqueta 0 → funciona
Hasta aquí, da igual. Pero a los dos días alguien —o tú mismo, tras un reset_index()— cambia el índice a algo con sentido de negocio:
df.index = ['A', 'B', 'C']
df.loc[0]    # KeyError: 'el índice no tiene la etiqueta 0'
df.iloc[0]   # primera fila, sin importar su etiqueta
El KeyError no es un bug, es información: te está diciendo que tu fila no se llama 0, se llama A. La sintaxis df.loc[0] no significa “la primera fila”, significa “la fila cuya etiqueta es 0”. Cuando lo interiorizas, el error deja de asustarte.
La trampa silenciosa: los rangos
Hasta ahora, “no funciona” es benigno: lanzas error, lo corriges, sigues. La trampa más fea es la del rango, porque no falla: devuelve un subconjunto distinto al que esperabas.
| Método | Selecciona por | Extremo superior |
|---|---|---|
.loc[a:b] | Etiquetas | Inclusivo |
.iloc[a:b] | Posición | Exclusivo |
Si vienes de Python puro, esperas que df.iloc[0:3] te devuelva las filas 0, 1 y 2 (exclusivo, como list[0:3]). Si lo escribes mal y pones df.loc[0:3] con etiquetas 0, 1, 2, 3, también funciona, pero por casualidad: lo que .loc hace es incluir el extremo. Con etiquetas no numéricas, la sorpresa es sistemática. Un rango de productos P002:P004 con .loc te incluye P004; con .iloc sobre la misma idea mental, no te lo incluye. Una fila de diferencia en producción es exactamente del tipo de bug que sobrevive a un code review.
Tres ejemplos donde se nota la diferencia
En la UT03 trabajamos con un inventario de tienda con códigos de producto:
df_inventory = pd.DataFrame({
    'Product': ['Laptop', 'Phone', 'Tablet', 'Monitor', 'Keyboard', 'Mouse'],
    'Price':   [999.99, 699.99, 299.99, 399.99, 79.99, 29.99],
    'Stock':   [15, 30, 25, 10, 50, 100],
}, index=['P001', 'P002', 'P003', 'P004', 'P005', 'P006'])

df_inventory.loc['P003', 'Price']   # 299.99
df_inventory.loc['P002':'P004']     # 3 filas, inclusivo
df_inventory.iloc[:3, :2]           # primeras 3 filas, primeras 2 columnas
Aquí la diferencia es neta: loc trabaja con P002, P003, P004; iloc trabaja con 0, 1, 2. Si mañana cambias el orden de las filas con un df.sort_values('Price'), los códigos siguen identificando el mismo producto, pero las posiciones no. Elige .loc cuando el dato tiene identidad propia; elige .iloc cuando solo te importa el orden físico. No son intercambiables: son dos lenguajes.
Y luego está el caso de los índices de fechas, que es donde más he visto tropezar:
fechas = pd.date_range('2024-01-01', periods=5)
df_fechas = pd.DataFrame({'valor': [10, 20, 30, 40, 50]}, index=fechas)

df_fechas.iloc[0]              # fila de 2024-01-01 (posición 0)
df_fechas.loc['2024-01-01']   # OK: acceso por etiqueta como string
df_fechas.loc[0] aquí sí falla: la etiqueta es la fecha completa, no el entero 0. Un KeyError que te recuerda que .loc no convierte tipos por ti.
Y el caso más útil en código real: la asignación. Modificar un valor con .loc es directo y se vectoriza limpiamente:
df_inventory.loc['P005', 'Stock'] = 0       # un valor
df_inventory.loc[df_inventory['Price'] > 500, 'Stock'] = 5   # condicional
La forma condicional (df.loc[mask, columna] = valor) aparece en cualquier pipeline serio: filtrar y modificar en una línea, sin bucles. Es el primer atajo que se echa de menos cuando vuelves a NumPy.
El caso que rompe en producción
Lo que la UT03 cuenta como “trampa típica” y donde más fallos he encontrado en producción es menos vistoso que un KeyError y más peligroso: el reset_index() silencioso. Estás limpiando Ames Housing, filtras las viviendas de un barrio concreto, haces df.reset_index(drop=True) para volver a un índice limpio, y todo parece bien. Pero el resto del notebook tiene df.loc[0] en seis sitios, y ahora 0 apunta a la primera vivienda de ese barrio filtrado, no a la primera del dataset original. No falla. Pasa los tests. Se va a producción. Devuelve resultados equivocados con cara de correctos.
Trabajas con etiquetas cuando la identidad del dato importa, y con posiciones cuando solo te importa el orden. Mezclar las dos cosas es la forma más rápida de escribir un bug que sobrevive a todas las pruebas.
Y si este tropezón te ha sonado familiar —porque te ha pasado, o porque sabes que te va a pasar— la siguiente parada natural es la UT03 — Pandas: El dialecto de los datos del libro, donde .loc, .iloc y la indexación se trabajan con un dataset real (Ames Housing) y con ejercicios de inventario como el de arriba. La idea es que la próxima vez que veas un KeyError sepas leerlo en vez de buscarlo en Stack Overflow. En Análisis de Datos con Python lo encadenas UT a UT.
¿A ti te dio más guerra el KeyError que grita o el rango que “casi funciona” sin avisar?